SD1.5 + LoRA로 게임 캐릭터 학습기 — SAM3 데이터 증강, Canny+OpenPose 병행, 리터치 자동화 (AI RPG 4편)
3편에서 이런 얘기를 했습니다. “로컬 컨트롤넷으로 뒷모습만 Gemini에 맡기는 하이브리드까지 왔다. 다음은 LoRA로 진짜 양산 체제로 가자.”
그게 이번 편입니다. 결론부터 말씀드리면 로라(LoRA)를 쓰면 프롬프트만 살짝 바꿔서 다양한 캐릭터를 뽑을 수 있을 거라 생각했는데, 예상보다 손이 많이 갔어요. 리터치는 불가피하다. 이게 이번 편의 결론입니다.
그럼 왜 그런지, 그 안에서 뭘 배웠는지 순서대로 정리해 보겠습니다.
LoRA 학습 데이터셋 만들기 — 촌장·어머니·소녀 캐릭터 추가
LoRA(Low-Rank Adaptation) 학습에는 이정표가 되는 데이터셋이 필요합니다. “이런 스타일로 그려달라”고 모델에 알려줄 참조 이미지 묶음이에요.
제가 3편까지 만들어둔 주인공 스프라이트 시트부터 트레이닝 데이터에 넣었습니다. 그런데 주인공 하나로는 스타일 학습이 부족해요. “우리 게임의 아트스타일”을 학습시키려면 여러 캐릭터가 필요합니다.
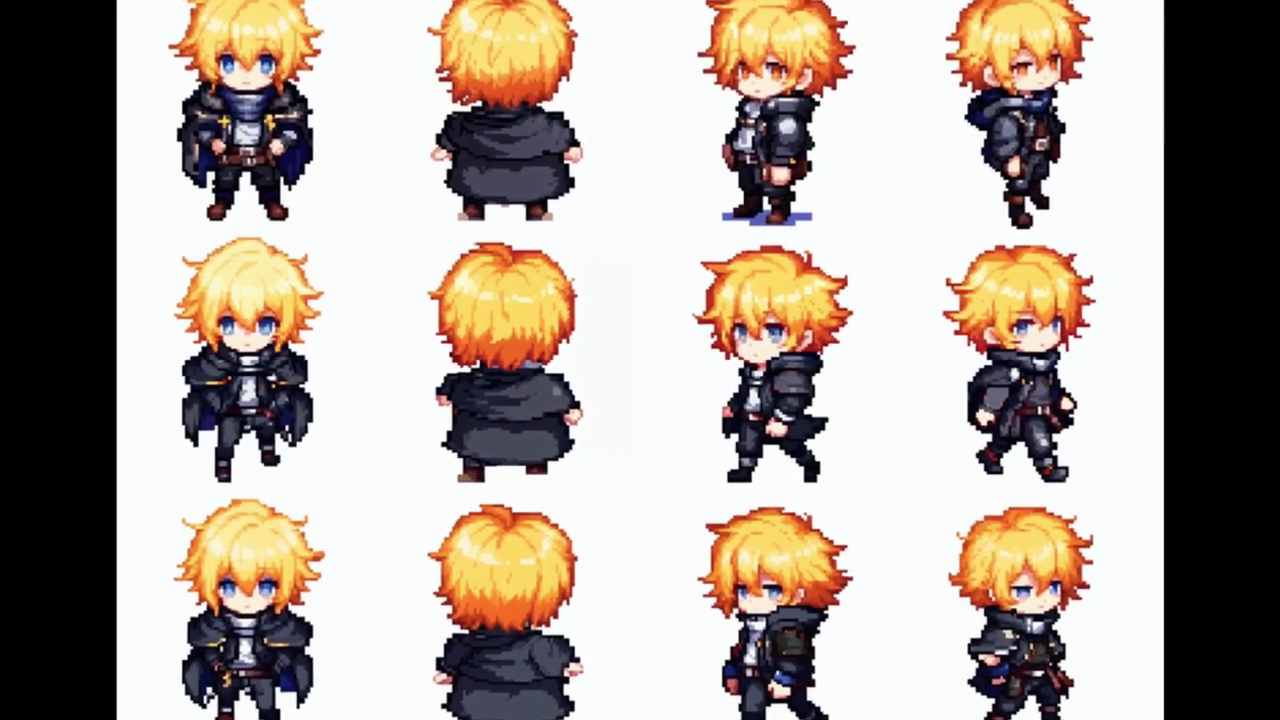
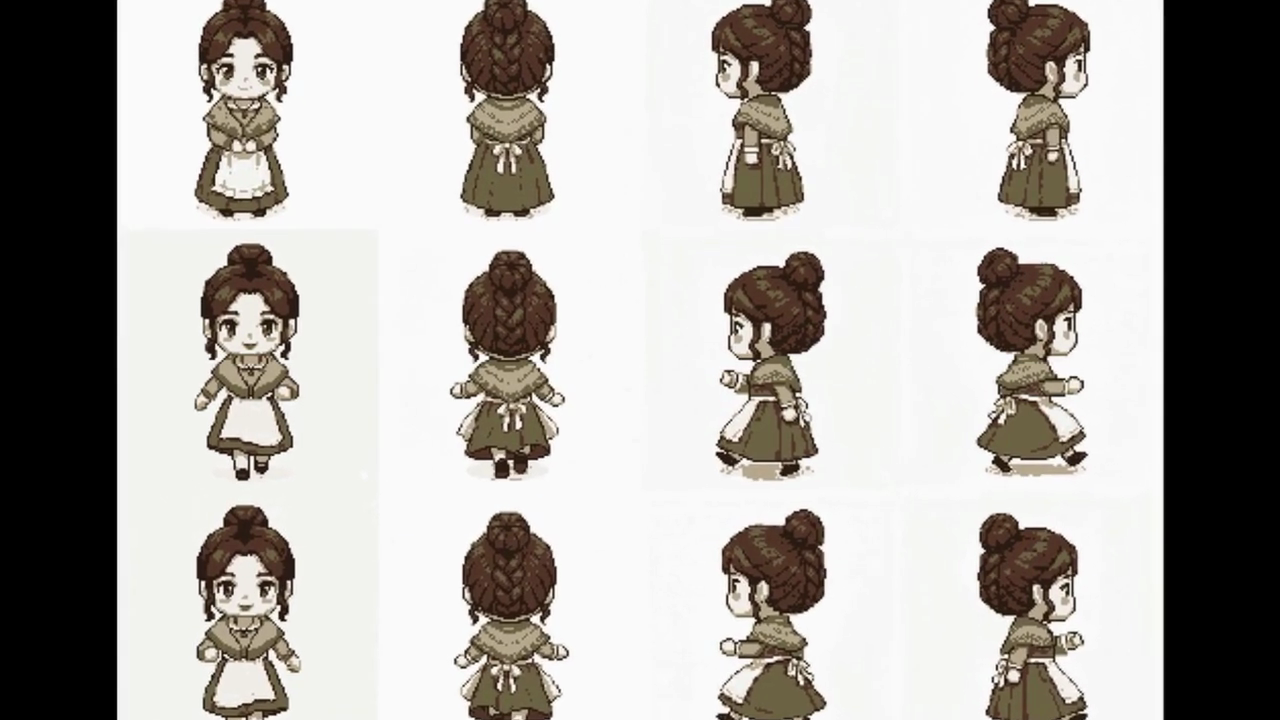
애당초 촌장님 덱으로 가서 대화하는 걸 게임 목표로 잡았으니 촌장님 이미지부터 추가했고요. 주인공 어머니 캐릭터도 넣었습니다. 촌장님과 어머니는 3편의 방법론(로컬은 안 됨) 그대로, Gemini(Nano Banana Pro)로 그렸어요. 내친김에 소녀 캐릭터까지 하나 추가해서 남녀노소를 맞춰봤습니다.
SAM3로 부분 마스크 → 색 바꿔가며 데이터 증강
몇 명 추가한 걸로는 여전히 데이터셋이 부족합니다. LoRA는 최소 수십 장 이상은 있어야 스타일이 안정적으로 학습돼요.
그래서 데이터 증강(data augmentation) 을 했습니다. 기존 이미지를 그대로 두고 부분적으로 색깔만 바꿔 여러 버전을 만드는 방식입니다.
핵심 도구는 SAM3(Segment Anything Model v3). 이미지에서 “머리카락”, “몸통” 같은 영역을 자동으로 마스킹해줍니다. 그 마스크에 색만 갈아 끼우면 같은 캐릭터의 다른 색 버전이 만들어져요.
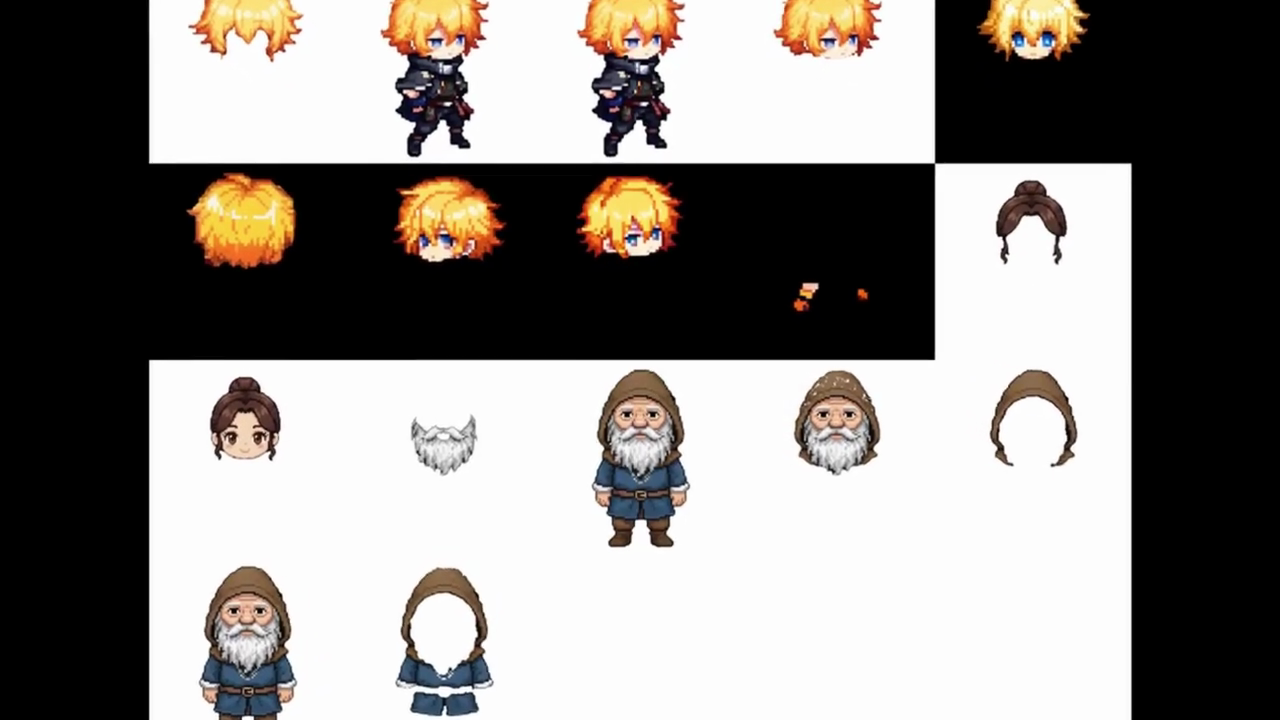
품질이 조금 떨어져도 됩니다. 특징점(feature)을 잡아주기 위한 용도니까요. 얼굴이나 옷의 정확한 색깔이 중요한 게 아니라 “머리카락 형태는 이렇게 생겼다”, “옷 실루엣은 이런 모양이다” 같은 구조적 정보가 데이터셋 전체 걸쳐 반복되면 됩니다.
그런데 흥미로운 발견 하나. Gemini로 만든 이미지는 증강 데이터 자체를 그대로 써도 될 정도로 품질이 좋았어요. 원래 Gemini 결과가 정갈해서 색만 갈아도 어색함이 없더라고요.
LoRA 트레이닝 결과 — “오우 오우 로라 로라 로라”
데이터셋이 준비됐으니 LoRA 모델을 트레이닝했습니다.
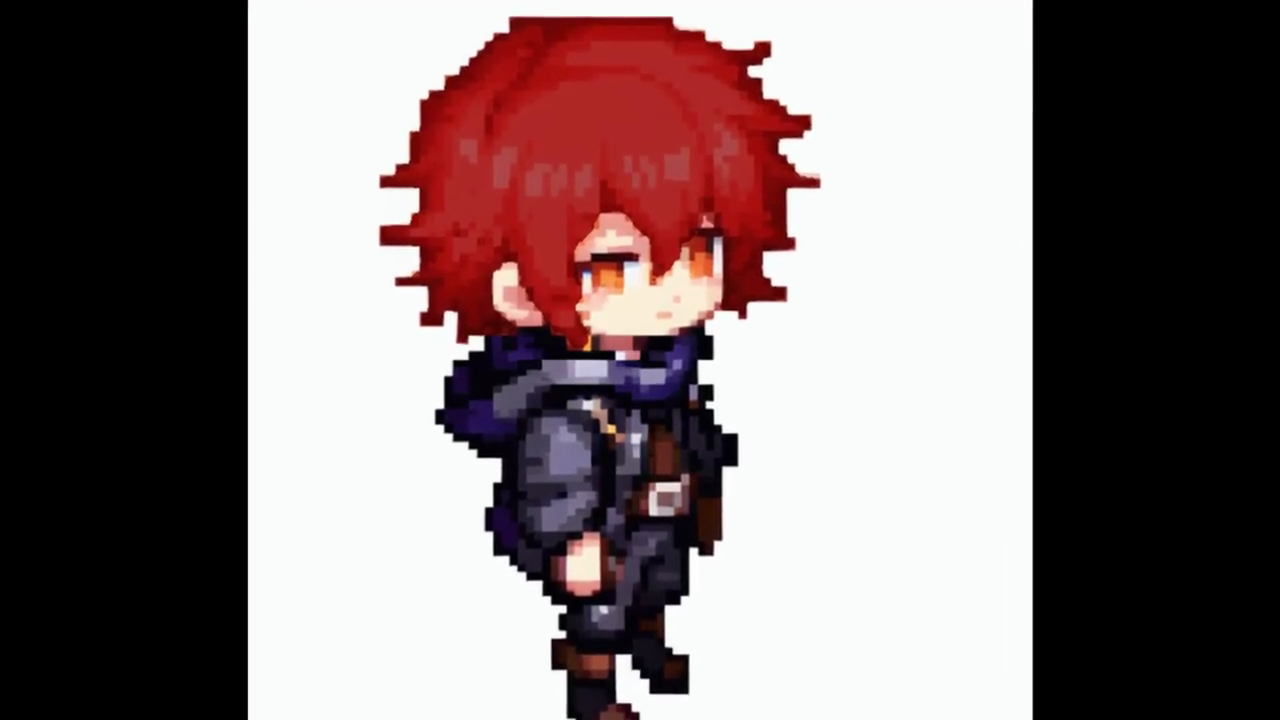
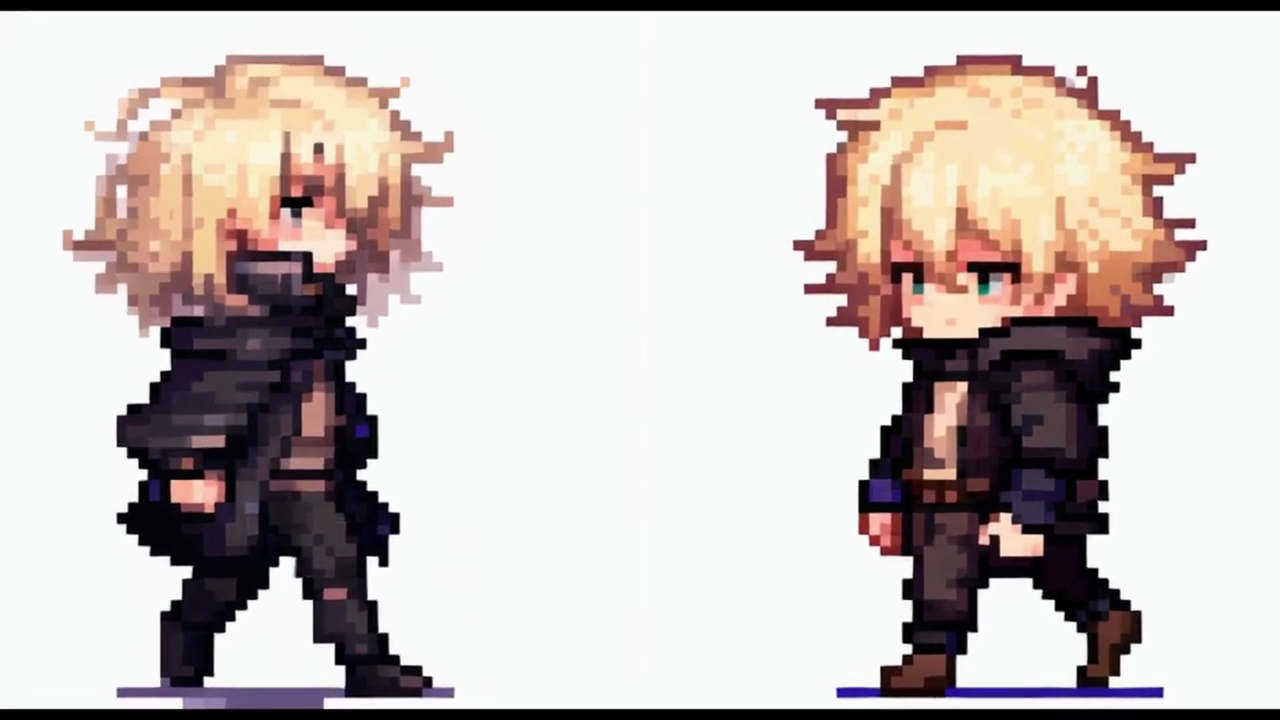
“회색 예상 금발 머리, 파란 눈을 가진 소년 캐릭터를 만들어달라” — 프롬프트 하나 던지고 결과 확인.
첫 인상은 좋았습니다. 오우 오우 로라 로라 로라! 스타일이 대략 살아있어요. 프롬프트만 바꾸면 다양한 캐릭터가 나올 것 같은 기대감.
Canny + OpenPose 재등장 — LoRA만으로는 각도·일관성이 안 잡힘
기대는 반쯤 맞았습니다. 앞모습은 정말 다양하게 표현 가능했어요. 프롬프트 하나 바꾸면 옷 색깔·헤어스타일·표정이 잘 바뀝니다.
문제는 각도와 일관성이었어요. 4방향(정면·측면·후면·다른 측면) 캐릭터 시트를 뽑으려니 각도별로 얼굴이 미묘하게 달라지고, 심지어 같은 각도 여러 장 뽑아도 머리카락 뻗침이 프레임마다 달랐습니다.
결국 3편에서 썼던 Canny + OpenPose를 그대로 얹게 되더군요. LoRA로 스타일 잡고, OpenPose로 포즈 통제, Canny로 실루엣 잠금. LoRA 하나로 다 해결될 줄 알았는데 로컬 컨트롤넷 스택을 모두 얹어야 겨우 안정됐어요.
콧수염 색깔, 머리 스타일 흔들림 — 프롬프트가 비대해지면 괴물이 나온다
컨트롤넷을 얹었어도 자잘한 흔들림이 남았습니다.
- 콧수염만 색깔이 미묘하게 달라짐 (같은 캐릭터 다른 프레임에서)
- 동작에 따라 머리 스타일이 달라짐 (걷기 프레임 → 서 있는 프레임 사이)
이런 문제들을 잡겠다고 프롬프트에 조건을 계속 추가했습니다. “콧수염 색은 X로 고정”, “머리는 짧은 웨이브 유지”, “옷 벨트 위치는 허리 중앙”…
그러다 만난 벽. 오히려 비대해진 프롬프트가 괴물을 만들어내버리는 상황. 조건이 많아질수록 모델이 어느 조건을 우선할지 판단을 못 하고 이상한 결과가 나오기 시작합니다. 트레이드오프예요.
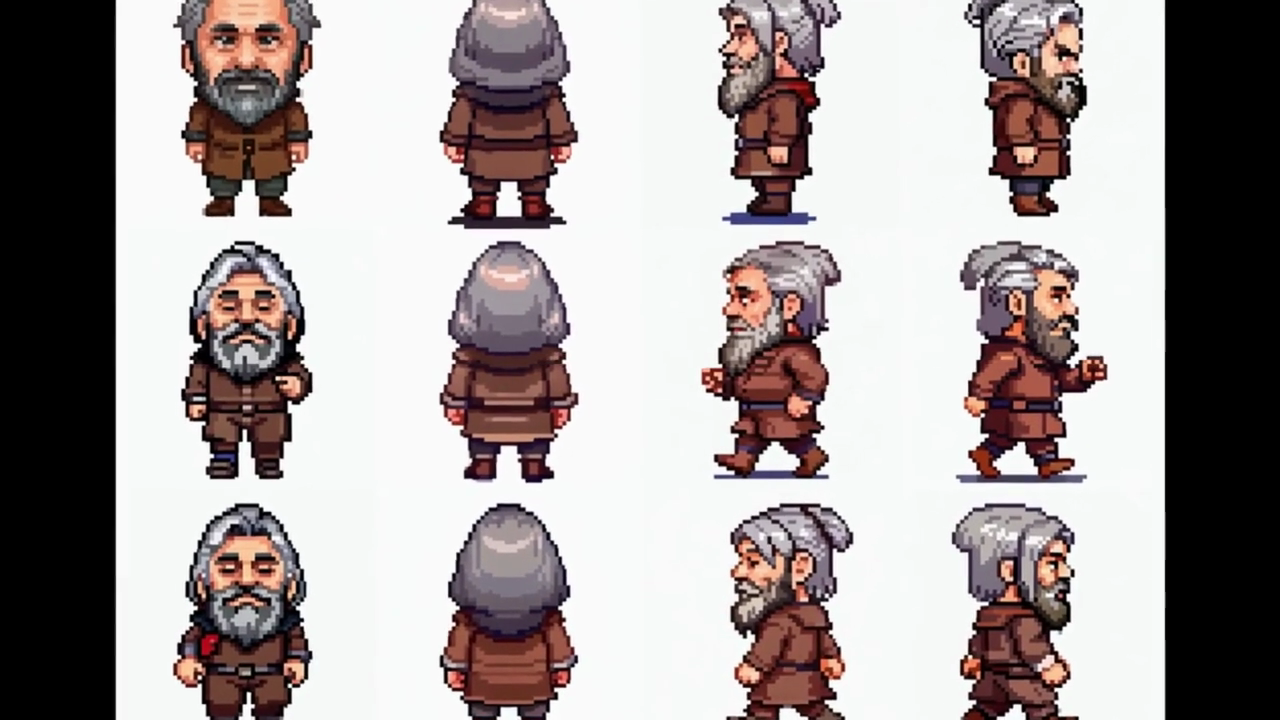
여기서 얻은 결론. 리터치는 불가피하다. AI로 100% 완벽한 스프라이트 시트가 나올 거라는 기대는 접기로 했습니다. 대신 리터치를 최대한 자동화하는 방향으로 갔어요.
리터치 자동화 — 각도별 선택 · 인페인트 · 컬러 오버레이
수동 리터치를 자동화한 방법 세 가지:
1. 각도별 대표 프레임 선택 얼굴이 조금씩 다르게 나오는 프레임 중에서 각도별로 하나만 고르게 해서 일관성을 높였습니다. 8장 뽑고 그중 정면 최고 1장, 좌측면 최고 1장… 이런 식.
2. 부분 마스킹 → 인페인트(inpaint) 의상 디테일이 프레임마다 미묘하게 다른 경우, 문제 부분만 마스킹해서 인페인트로 재생성. 전체를 다시 그리는 게 아니라 문제 구간만 손보는 겁니다.
3. 컬러 오버레이 색깔만 살짝 어긋난 경우에는 인페인트까지 갈 것 없이 해당 영역에 색 오버레이만 얹어서 통일. 가장 싼 방법.
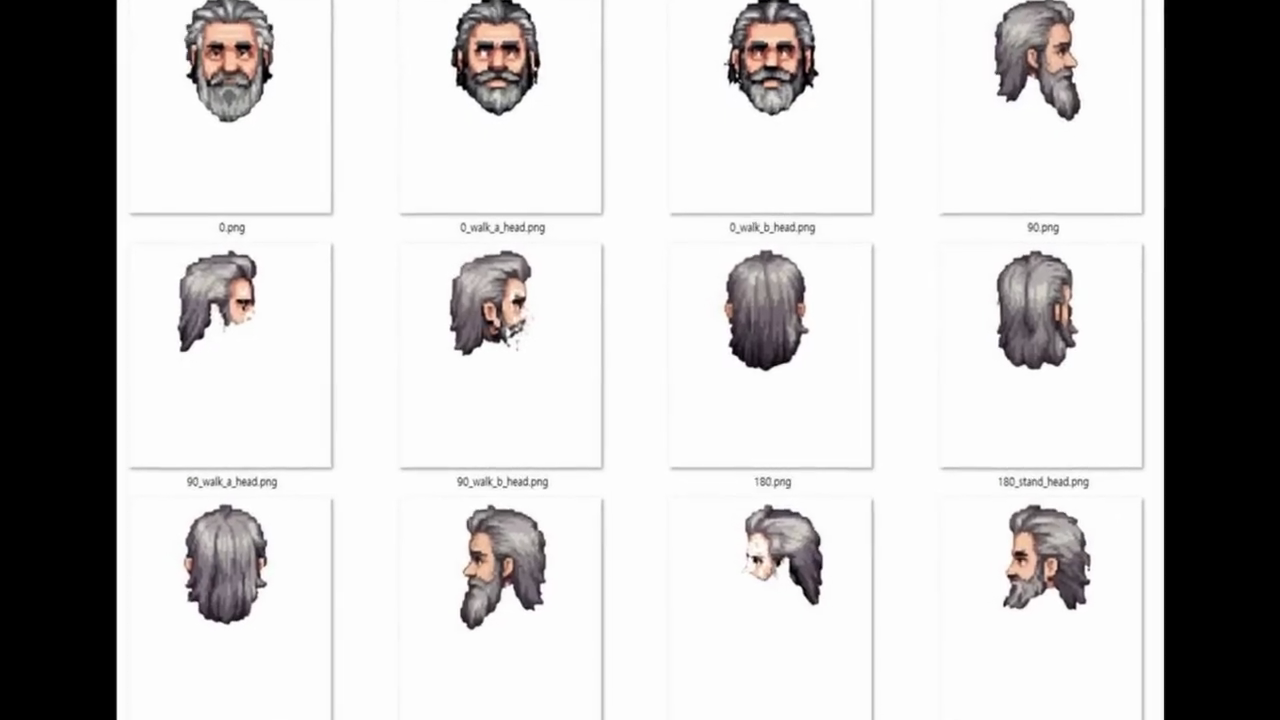
도저히 안 되는 경우는? 직접 그려서 바꿀 수밖에 없었어요. AI가 못 하는 마감은 결국 사람 손이 필요합니다.
캐릭터당 1시간 — “GPU 바꿔야, 그런데 총알이 없다”
여기까지 정리하면 파이프라인은 완성돼요. 문제는 속도.
최종 리파인 이미지까지 한 번 뽑는 데 캐릭터당 1시간이 걸립니다. 답답해 뒤지겠어요. NPC 50명이면 50시간. 하루 종일 돌려도 며칠 걸리는 계산.
원인은 명확해요. 로컬 GPU가 SD1.5 세대라 SDXL 이상 모델 돌리기엔 부담이었습니다. VRAM도 부족하고 코어도 옛날 것.
결론은 GPU를 바꿔야 한다는 거고요. 하지만 총알(돈)이 부족해서 계속 답답해 뒤져야 하고요. 이걸 유튜브 영상에서 “똥PU” 라고 자조했는데, 이번 편 제목의 로라~ 로라! 로라?와 함께 이 편의 두 유머 축이에요.
애기 엄마 컴퓨터로 몰래 Gemini — 몬스터 그리기
똥PU가 답답해서 밤새 리파인을 돌리는 동안 뭐라도 하고 싶었어요. 그래서 애기 엄마 컴퓨터에 몰래 접속해서 Gemini로 몬스터 캐릭터를 몇 개 그렸습니다.
다행히 안 걸렸고요. 스릴 넘쳐서 집중이 잘 된 건 비밀입니다.
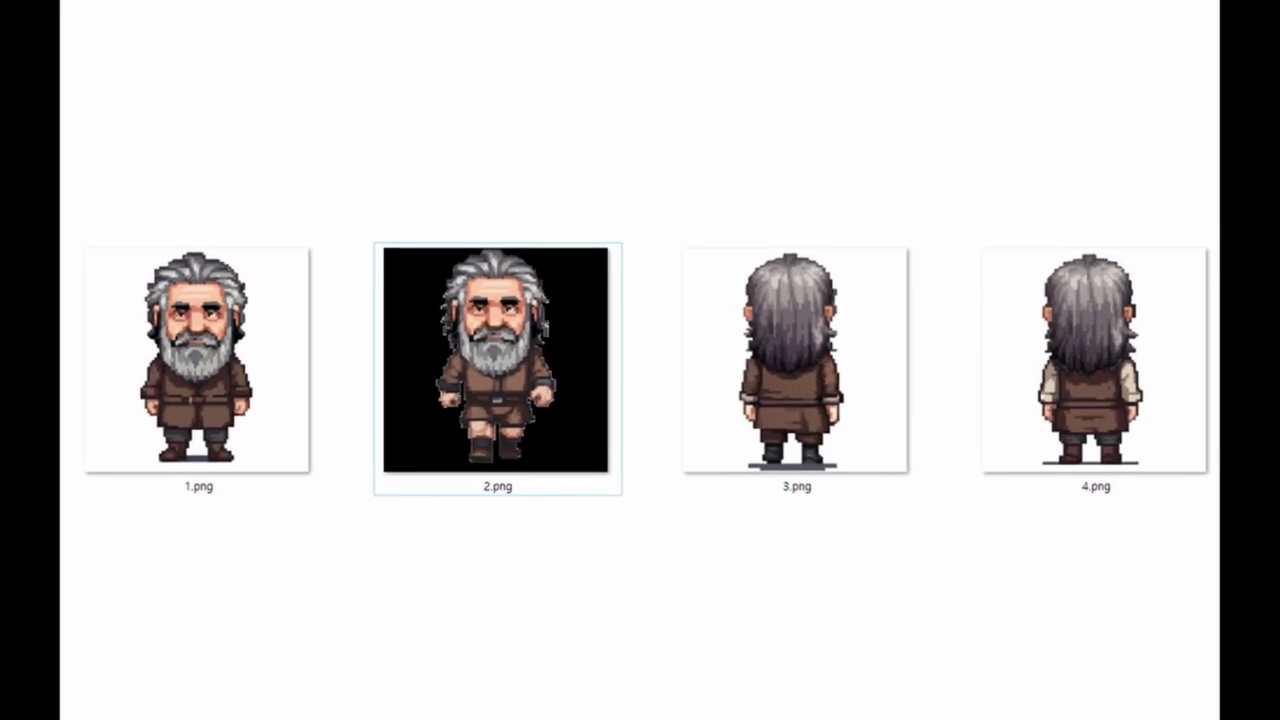
그리고 제 똥PU가 밤새서 그린 최종 캐릭터 시트를 공유하면서 이번 편을 마치겠습니다.
정리 — LoRA는 마법이 아니고, 리터치는 불가피하다
이번 편의 교훈을 한 줄씩 정리하면:
- LoRA 학습에는 데이터셋이 필요하고, 데이터셋 확보엔 여전히 Gemini + SAM3 증강 조합이 유효.
- LoRA로 스타일은 잡히지만 각도·일관성은 안 잡힘. 3편의 OpenPose + Canny 컨트롤넷 스택을 여전히 얹어야 함.
- 프롬프트 조건을 계속 추가하면 오히려 결과가 무너진다. 어느 지점에서는 멈춰야 함.
- 리터치는 불가피하다. 대신 각도별 선택·인페인트·컬러 오버레이로 최대한 자동화.
- GPU 병목이 진짜 병목이다. SD1.5 세대 로컬 GPU로는 캐릭터당 1시간. SDXL·플럭스 세대로 가려면 하드웨어 업그레이드 필요.
시리즈 흐름 정리
- 1편: SDXL Turbo로 맵·SAM v3로 마스크. 캐릭터는 실패
- 2편: Gemini(Nano Banana Pro)로 캐릭터 일관성 해결. API 비용 문제
- 3편: 로컬 IPA + OpenPose + Canny 3중 컨트롤넷 + 뒷모습만 Gemini 하이브리드
- 4편(이번): LoRA로 스타일 학습. 하지만 컨트롤넷 스택 유지 + 리터치 불가피. GPU 병목 확인
- 다음 편: GPU 업그레이드 이후, 또는 그 전 다른 접근?
다음 시간에 만나요. 제발.
Comments