시스템 설계 시뮬레이터에 부분 OOM과 오토스케일링 붙이기 (breakscale_wrap)
Breakscale은 설계도를 그리면 트래픽을 흘려 보며 어디가 먼저 막히는지 보여 주는 오픈소스 시스템 설계 시뮬레이터입니다(MIT). Claude Code에서 MCP로 붙여 쓸 수 있어서, 처음에는 “아키텍처 설명용 그림과 문서를 자동으로 만들 수 있을까”를 확인하려고 만져 봤어요.
그러다 원본으로는 표현할 수 없는 장애가 눈에 들어왔고, 결국 원본을 감싸는 도구를 하나 만들었습니다. 10월 16~17일 이틀 동안 Claude Code와 같이 만든 breakscale_wrap입니다.
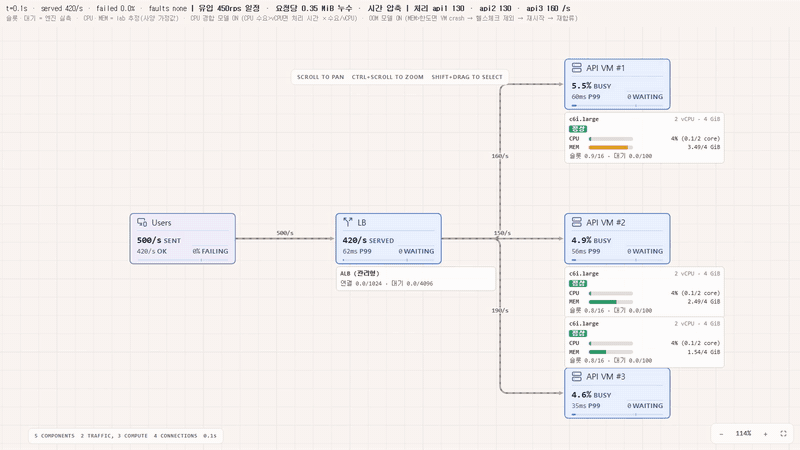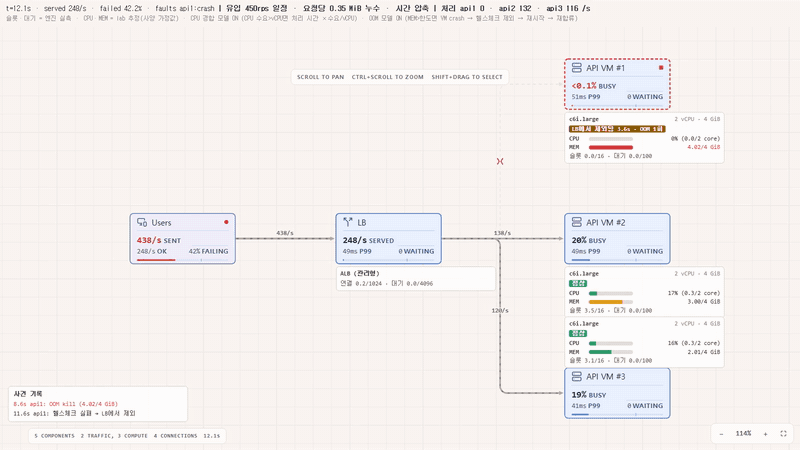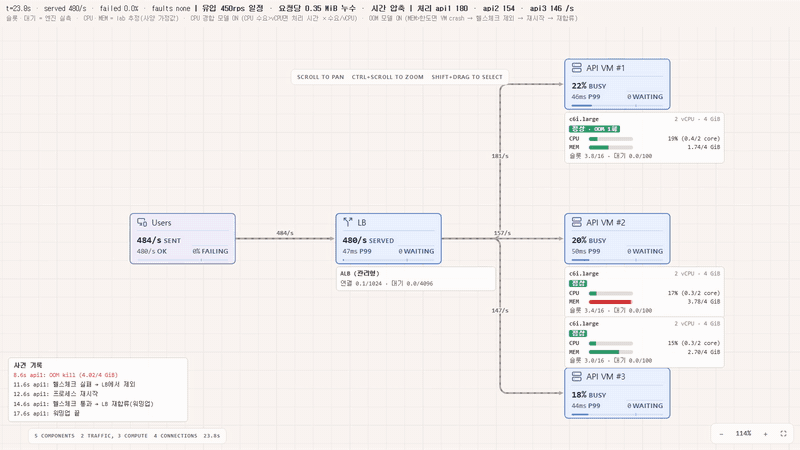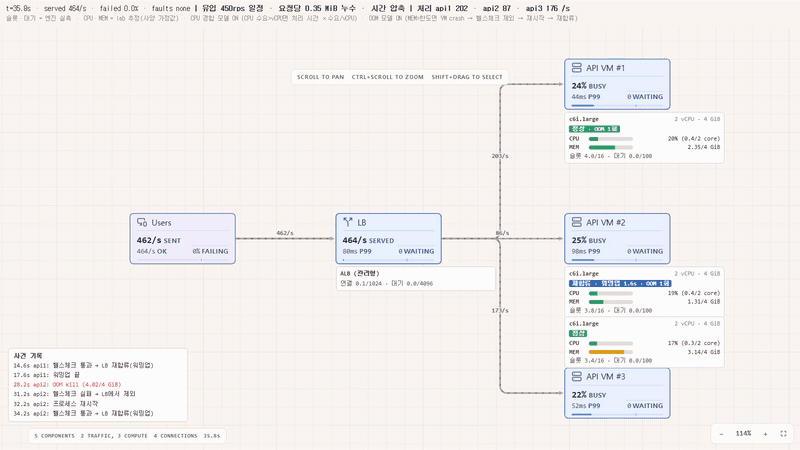
시작은 “CPU나 메모리 사양도 넣을 수 있나?”였다
Breakscale은 큐 적체, DB 쓰기 락, 서킷브레이커, 오토스케일러 워밍업 지연 같은 구조에서 생기는 현상을 잘 보여 줍니다. 그런데 컴포넌트를 설정하다 보니 메모리 크기나 CPU 사양을 넣는 칸이 보이지 않았어요.
소스를 확인해 보니 이랬습니다.
- 웹 화면에는 AWS·GCP·Azure 사양 목록이 있지만, 결과에 반영되는 건 vCPU 1개 = 동시 처리 슬롯 1개라는 규칙 하나뿐입니다.
- 메모리·네트워크·IOPS는 화면에 글자로만 나오고 계산에는 쓰이지 않습니다.
instances: 3처럼 여러 대를 지정해도 슬롯을 하나로 합쳐 계산합니다. 기계별 상태가 없습니다.
이건 버그가 아니라 원칙이었어요. 원본 개발 규칙에 “시뮬레이터가 보여 주는 숫자는 측정값이어야 한다”고 적혀 있고, 같은 DB 사양이라도 쿼리에 따라 초당 5만 건도, 20건도 처리하니 앱마다 달라지는 값은 일부러 두지 않는다는 거죠. 공식 이슈 https://github.com/xevrion/breakscale/issues/29에도 같은 문제 제기가 열려 있었고, 저장소 주인은 그 원칙을 지키면서 할 방법을 고민 중이라고 답해 둔 상태였습니다.
원칙은 이해가 됐지만, 그러면 실전에서 흔한 장애 몇 가지를 아예 그릴 수 없습니다.
| 실전에서 흔한 상황 | 원본 Breakscale |
|---|---|
| CPU가 모자라 요청이 느려짐 | 슬롯만 남아 있으면 동시 처리가 늘어도 느려지지 않음 |
| 여러 대 중 1대만 OOM으로 죽음 | 기계별 메모리가 없어서 표현 불가 |
| 헬스체크가 잡기 전까지 LB가 죽은 서버로 계속 보냄 | 헬스체크 개념 없음 |
| 과부하로 헬스체크 응답이 늦어져 서버가 연달아 빠짐 | 표현 불가 |
하드웨어는 고정값, 구현 방식은 변수
여기서 제 생각은 이랬습니다. 같은 c6i.large라도 API 서버를 어떻게 구현했느냐에 따라 CPU를 온전히 쓸 수도, 못 쓸 수도 있어요. LB나 큐는 클라우드 사양을 따르겠지만, 앱 서버의 “요청 하나가 CPU와 메모리를 얼마나 쓰는가”는 결국 예측치입니다.
그렇다면 그 값을 변수로 드러내고, 부하 테스트로 잰 실측값이 있으면 그걸 넣고, 없으면 올렸다 내렸다 하며 보면 됩니다. 원본이 “모르는 값은 안 보인다”를 택했다면, 저는 “모르는 값은 가정이라고 표시하고 바꿔 볼 수 있게 한다”를 택한 셈이에요.
그래서 처음부터 원칙을 두 가지로 정했습니다.
- 원본은 한 줄도 고치지 않는다. 원본 엔진은 import만 하고, 원본에 이미 있는 장애 주입(
crash·slow·partition)과 대수 조절을 바깥에서 조작한다. - 엔진이 잰 값과 우리가 추정한 값을 항상 나눠 표시한다. 슬롯·대기열·처리량·지연은 엔진 실측, CPU·메모리·헬스체크 응답·증설 판단은 lab 추정.
첫 번째로 붙인 것: CPU 경합 모델
첫 결과물은 CPU 경합 모델이었습니다. 처리 중인 요청 수 × 요청당 CPU 사용 비율이 vCPU 수를 넘으면, 처리 시간을 그 비율만큼 늘리는 방식이에요. 처리량 상한이 이론값과 -0.3~+1.7% 안에서 맞는 것까지 확인했습니다.
이 모델이 잘 드러나는 장면은 “성격이 다른 두 트래픽이 같은 VM을 나눠 쓰는 경우”입니다. 예를 들면 PDF 출력 전용 인스턴스 하나가 발표 자료용 PDF와 과제물용 PDF를 같이 만드는 식이죠. 상용 클라우드에서는 노드 하나에 VM 여러 대를 묶어 쓰는 구성이 흔치 않지만, 서버 한 대에 여러 서비스를 올려 쓰는 온프레미스 환경이라면 이 모델로 그대로 시뮬레이션해 볼 수 있습니다. 여러 노드가 vCPU 풀 하나를 같이 쓰도록 묶는 설정도 넣어 두었어요.
여기에 개선 사항을 하나 더 붙였습니다. OOM은 실제로 자주 겪는 장애인데, 그걸 표현하지 못하는 건 원본의 분명한 한계였으니까요. CPU 경합 모델은 그대로 두고 부분 OOM을 추가했습니다.
부분 OOM: 원본 안에서 1대만 멈추려다 방향을 바꿨다
처음 고른 방법은 원본 노드는 그대로 두고 장애에 “OOM 때문”, “CPU 100% 때문” 같은 이유를 우리 쪽에서 붙인 뒤, 원본의 대수 조절로 인스턴스 1대만 빼는 방식이었어요. 원본 오토스케일러도 그대로 쓸 수 있으니 가장 덜 건드리는 길이었습니다.
시험해 보니 대수를 3대에서 2대로 줄이면 처리량이 이론값대로 1200/s에서 약 795/s로 떨어졌습니다. 여기까지는 좋았는데, 예측용으로 쓰기엔 걸리는 점이 세 가지 나왔어요.
- 죽는 순간 처리 중이던 요청이 실패하지 않습니다. 대수를 줄여도 처리 중인 요청은 끝까지 처리됩니다. 실제로는 바로 실패하죠.
- LB가 죽은 서버로 계속 보내는 구간이 없습니다. 슬롯을 하나로 합쳐 계산하니 결과가 낙관적으로 나옵니다.
- 원본 오토스케일러가 우리가 뺀 대수를 덮어씁니다. 6초에 1대를 뺐는데, 오토스케일러가 자기가 기억하는 3대를 기준으로 4대 증설을 결정해서 죽여 둔 1대까지 되살렸어요.
그래서 방향을 바꿨습니다. VM 1대를 노드 1개로 나누고, 오토스케일러는 직접 만든다. 노드를 나누면 원본의 crash가 그 VM의 처리 중·대기 요청을 모두 실패시키고, LB가 죽은 VM으로 보내는 구간도 원본 엔진 안에서 그대로 계산됩니다. 대신 원본 오토스케일러는 포기해야 했어요.
이때 재미있는 현상도 하나 봤습니다. 원본 LB는 기본으로 “가장 한가한 곳”에 보내는데, 죽은 노드는 요청을 바로 실패시키니 늘 한가해 보여서 트래픽이 오히려 그쪽으로 몰립니다. 헬스체크 없이 least-connection을 쓰는 실제 LB에서도 생기는 일이라, 헬스체크 모델이 왜 필요한지 보여 주는 장면이 됐어요.
죽은 VM은 어떻게 돌아오나
VM을 빼는 건 실전에서도 공통입니다. ALB는 헬스체크에 실패한 대상에 보내지 않고, 쿠버네티스는 readiness 검사에 실패한 Pod를 뺍니다. 그런데 “다시 돌아오는 게 같은 VM이냐”는 운영 방식마다 달라서, 복구 방식을 세 가지로 고를 수 있게 했습니다.
| 복구 방식 | 다시 들어오는 대상 | 남는 것 |
|---|---|---|
| 프로세스 재시작(systemd 등) | 같은 VM | 디스크 파일은 남고 메모리 캐시는 사라짐 |
| 컨테이너 재시작(쿠버네티스) | 같은 Pod | 반복해서 죽으면 재시작 대기가 점점 길어짐(백오프) |
| VM 교체(오토스케일링 그룹) | 새 VM | 전부 사라지고 부팅부터 다시 |
어느 경우든 메모리 캐시는 비기 때문에, 재합류 직후에는 느린 워밍업 구간을 넣었습니다.
자체 오토스케일러와 헬스체크 경로
오토스케일러는 평균 CPU 목표 추적(쿠버네티스 HPA 방식)으로 만들었습니다. 최대 대수만큼 VM 노드를 미리 그려 두고 꺼진 VM은 화면에서 숨기는 방식이에요. 증설 쿨다운, 축소 전 관찰 구간, 축소할 때 처리 중인 요청을 마무리하는 드레이닝도 넣었습니다.
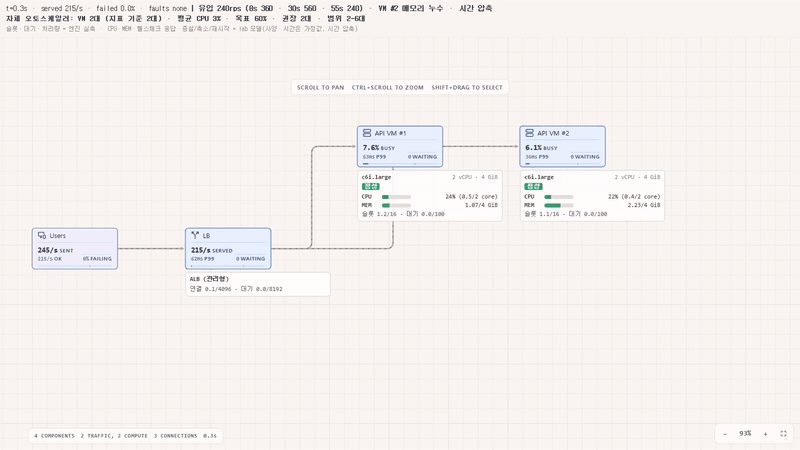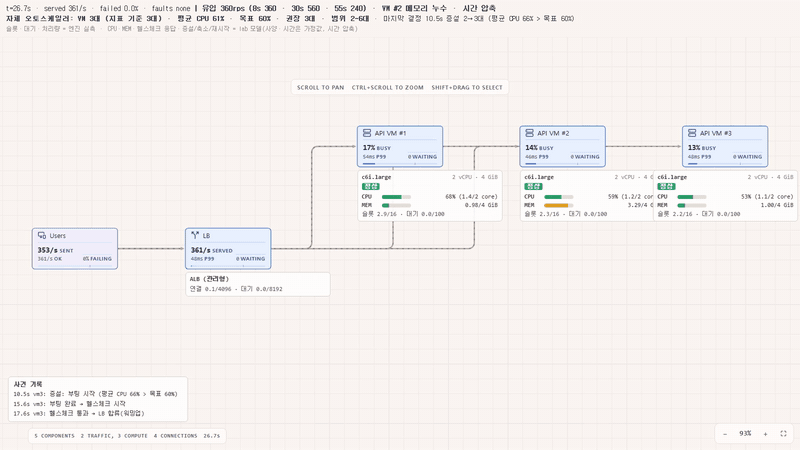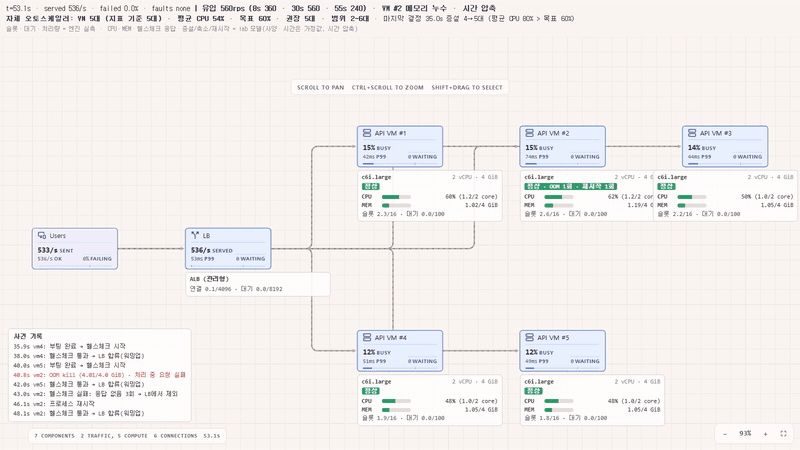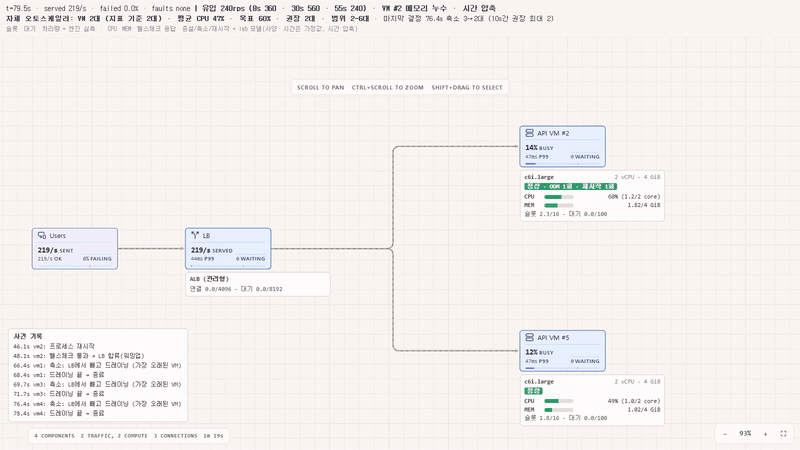
만들고 나서 급증 시나리오를 돌려 보니, 증설이 늦는 사이에 과부하 → 헬스체크 응답 지연 → LB에서 제외 → 남은 VM에 더 몰림의 연쇄가 생겼습니다. 결과를 가른 건 헬스체크를 어떻게 구현했느냐였어요.
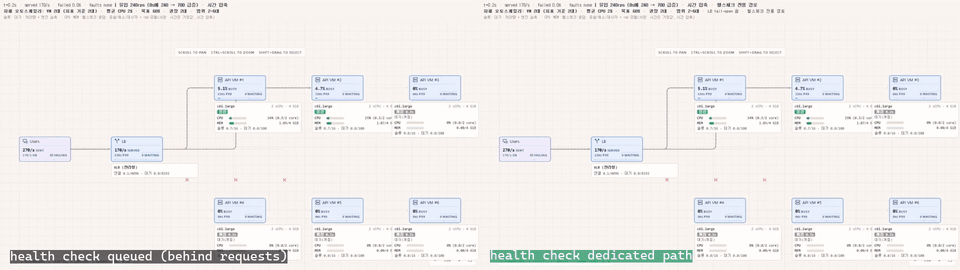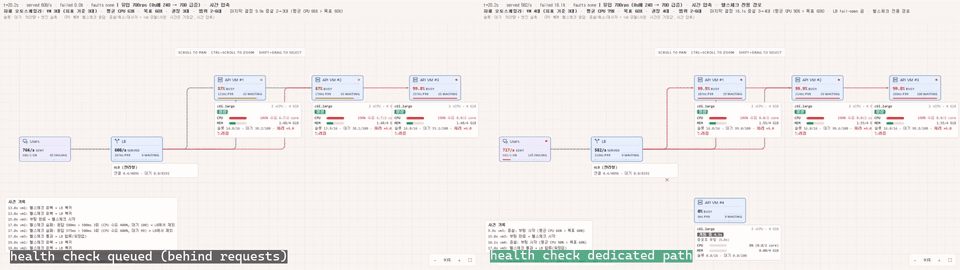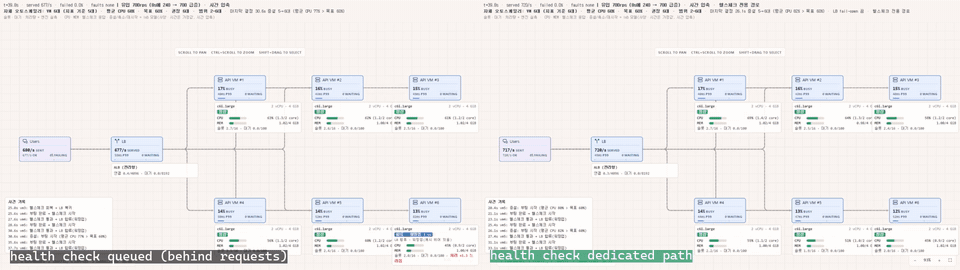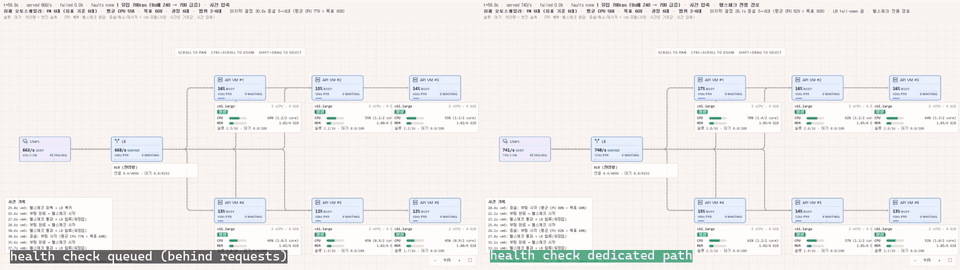
헬스체크가 일반 요청과 같은 대기열에 서면(왼쪽) 바쁜 VM이 “죽었다”고 판정돼 연달아 빠집니다. 전용 경로로 응답하면(오른쪽) 넘치는 요청만 거절되고 VM은 남아요. 그래서 시나리오에서 헬스체크 경로를 고를 수 있게 했습니다.
AWS ALB의 fail-open도 넣었습니다. 대상이 전부 헬스체크에 실패하면 차라리 전부에게 보내는 동작인데, 같은 급증 시나리오에서 켜 보니 그 구간 실패율이 81%에서 15%로 내려갔고, 40초 동안 성공한 요청은 14,204건에서 16,243건이 됐습니다(가정값으로 돌린 결과입니다).
원본을 안 고쳤다는 걸 어떻게 확인하나
감싸는 도구가 원본 결과를 왜곡하면 의미가 없으니 검증부터 붙였습니다.
- 회귀 비교: 우리 컨트롤러를 모두 끄고 돌린 결과가 공식 MCP 응답 23건과 글자 단위로 같아야 합니다(23/23).
- 계산으로 답이 나오는 경우 대조: CPU 경합만 켰을 때 처리량 상한이 이론값 V/(p·s)와 맞는지, OOM·헬스체크·재시작·재합류 시각이 설정대로 나오는지, 오토스케일러의 대수 계산·드레이닝·fail-open이 맞는지 스크립트로 확인합니다.
원본은 특정 커밋에 고정해 두고, 설치 스크립트가 그 커밋을 받아 빌드합니다. 원본을 올릴 때는 회귀 비교부터 다시 돌리는 구조예요.
사용법
Git, Bun 1.2 이상, Node.js 20 이상이 필요합니다(영상 녹화는 ffmpeg).
git clone https://github.com/reddol18/breakscale_wrap.git
cd breakscale_wrap
node lab/setup.mjs        # 원본 받기·고정·빌드, 의존성, 녹화용 Chromium
bun lab/regress.ts        # "23/23 same"이 나오면 정상
저장소 폴더에서 Claude Code를 열면 CLAUDE.md에 적힌 절차대로 자연어 요청을 시나리오 파일로 옮겨 돌려 줍니다.
쇼핑몰 주문 API를 ALB 뒤 c6i.large 2대로 운영 중이야. 평소 초당 250건인데 이벤트 때 순간 3배가 와. CPU 60%에서 증설하고 최대 6대, 부팅은 3분 걸려. 헬스체크는 일반 요청과 같은 스레드에서 처리해. 이벤트 때 어떻게 되는지 시뮬레이션해서 영상까지 만들어 줘.
요청당 CPU, 처리 시간, 메모리 같은 실측값을 안 주면 기본값을 넣고 어떤 값을 가정했는지 밝힙니다. 직접 쓰려면 시나리오 JSON 하나를 lab/scenarios/에 두고 돌리면 됩니다.
bun lab/sim.ts example_spike --every 5     # 시각별 처리·실패·VM 상태, 사건 기록, 요약
node lab/viz/serve.mjs                     # 화면: http://127.0.0.1:4180/?scn=example_spike
한계
- 값은 가정입니다. 예제의 요청당 CPU·메모리·누수, 부팅·헬스체크 시간은 설명용이고 영상은 시간을 압축했습니다. 예측에 쓰려면 실측값으로 바꿔야 해요.
- 헬스체크 응답 시간은 추정입니다. 엔진이 재는 값이 아니라 처리 시간·느려짐 배율·대기열 길이로 계산합니다.
- LB 분배는 원본의 두 가지(가장 한가한 곳, 가중치 비율)뿐입니다. 라운드로빈이나 해시가 결과를 좌우하는 설계라면 원본을 고치지 않고는 예측할 수 없어요.
- CPU 경합은 일반 서비스 노드에만 적용됩니다. 원본의
slow장애가 DB처럼 자체 슬롯을 쓰는 종류에는 먹히지 않아서입니다. 원본 주석과 다른 동작이라 따로 기록만 해 두었습니다. - lab 결과는 Breakscale 공유 링크에 남지 않습니다. 영상이나 로컬 화면으로만 보여 줄 수 있어요.
다음에 할 일
두 가지가 남아 있습니다. 둘 다 가능한지만 확인해 뒀고, 실제로는 GCP나 AWS에서 나중에 해 볼 생각이에요.
- 이미 운영 중인 구성을 시뮬레이션으로 옮기기.
gcloud같은 클라우드 명령으로 구성을 읽어 오면, 그걸 LLM이 이 도구의 시나리오로 해석하는 흐름입니다. 도구에 기능으로 넣을 필요는 없고 프롬프트로 충분하다고 봅니다. - 시뮬레이션 비용 계산. 시뮬레이션이 이미 과금 대상 VM-초를 내고 있어서, 시간당 가격만 곱하면 “이 이벤트를 버티는 데 컴퓨팅 비용이 얼마”까지 나옵니다.
학습용 시뮬레이터를 “부하 테스트 실측값을 넣으면 실제 트래픽 상황을 미리 보여 주는 도구”로 쓰는 게 목표입니다. 원본이 지키는 “측정값만”이라는 원칙 덕분에, 어디까지가 엔진이 잰 값이고 어디부터가 제 가정인지 선을 긋기가 오히려 쉬웠어요.
- 깃헙: https://github.com/reddol18/breakscale_wrap (MIT)
- 원본: https://github.com/xevrion/breakscale (MIT)
Comments