클로드 코드 메모리, 토큰은 줄이고 기억은 정확하게 — LLM 에이전트용 기록 장부 MCP 서버 네멘토(Mnemento) 소개
네멘토(Mnemento) — 세션이 끝나면 잊는 AI를 위한 기록 장부
AI 에이전트와 오래 일하다 보면 같은 장면을 반복해서 보게 됩니다. 어제 분명히 같이 정리했던 내용을, 오늘 새 세션의 에이전트는 모릅니다. 대화가 길어져서 요약되면 그 전의 세부 사항도 사라지고요. 그래서 에이전트는 메모 파일에 의지합니다. 그 메모가 정확할 때까지는요.
이번에 그 문제를 풀려고 만든 오픈소스 프로젝트를 소개합니다. 이름은 Mnemento, 한국어로 읽으면 네멘토입니다.
👉 GitHub: https://github.com/reddol18/mnemento (MIT License)
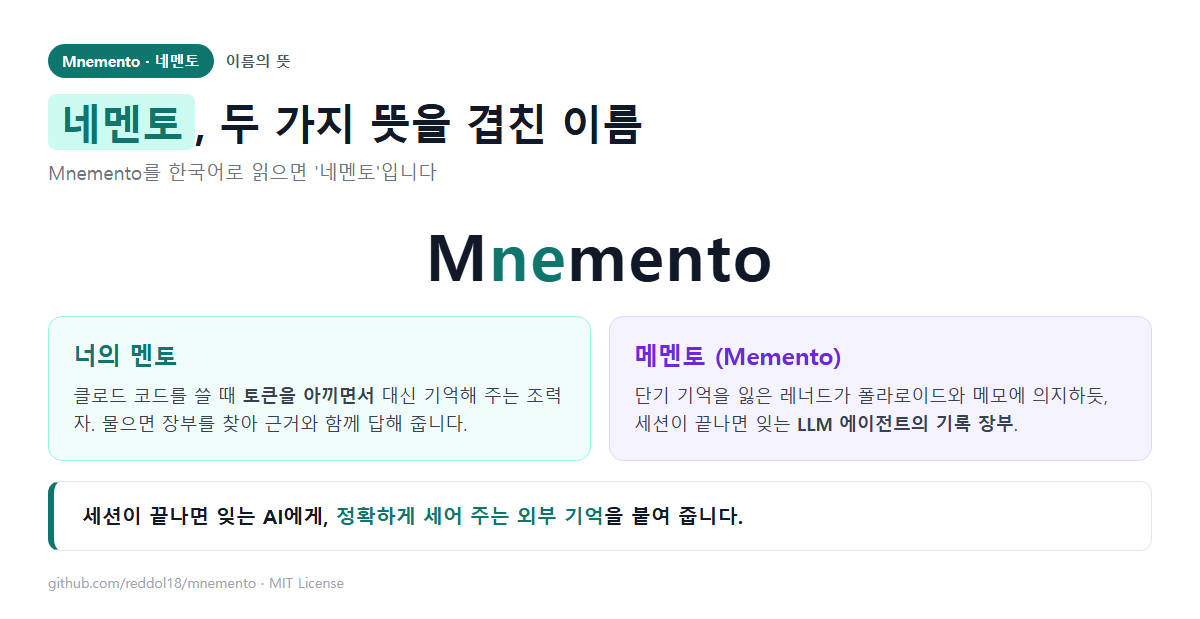
이름의 뜻 — “너의 멘토”이자 “메멘토”
네멘토라는 이름에는 두 가지 뜻을 겹쳐 넣었습니다.
- 너의 멘토 — 클로드 코드를 쓸 때 토큰을 아끼면서도 기억을 대신 해 주는 조력자. 물어보면 장부를 찾아서 근거와 함께 답해 줍니다.
- 메멘토(Memento) — 크리스토퍼 놀란의 영화 메멘토에서 주인공 레너드는 단기 기억을 잃은 채, 폴라로이드 사진과 몸에 새긴 메모에 의지해 판단합니다. 세션이 끝나면 잊어버리는 LLM 에이전트의 처지가 딱 그렇습니다. 그 상황에 빗대어 비슷하게 지은 말입니다.
README 첫 줄도 이렇게 시작합니다. “Like Leonard’s polaroids in Memento — a shared, structured record book for LLM agents.”
문제의식 — 클로드 코드 메모리 파일로는 “정확하게 세기”가 어렵다
직접 에이전트를 운영하면서 실제로 겪은 문제들입니다.
- 기록이 형식이 다른 여러 곳에 흩어졌습니다. 메모리 마크다운, HTML 속 JSON, 산출물 대장, 웹 페이지의 localStorage.
- 그 결과 “오늘 구직 플랫폼에 지원한 곳이 몇 곳?”을 하나 적게 셌습니다. 메모의 애매한 문구를 “패스”로 잘못 읽었고, 지원완료 메일이라는 근거와 대조할 수단이 없었습니다.
- “이 회사에 예전에 지원했나?”에 답하려면 HTML과 대화 기록을 grep 해야 했습니다.
- 일반 DB에 MCP를 붙여 자연어로 물어봤더니, LLM이 스키마를 몰라서 질의를 짐작했고 답이 부정확했습니다.
기존 에이전트 메모리 도구(mem0 OpenMemory, Supermemory, Letta 등)는 대부분 비슷한 문장을 찾아오는 벡터 검색입니다. “비슷한 이야기”를 찾는 데는 좋지만, “10월 2일에 지원한 곳이 몇 곳이냐” 같은 조건 질의에는 약합니다.
그래서 목표를 이렇게 잡았습니다.
- 여러 에이전트가 하나의 장부에 사실을 기록하고, 자연어로 물으면 정확한 조건 질의로 답한다.
- 모든 답에 근거(어떤 기록으로 셌는지)를 붙인다.
- 확실하지 않은 입력은 저장하지 않고 되묻는다.
- 그리고 이 모든 게 Claude Code 자체 메모리만 쓸 때보다 정확도는 같거나 높고, 더 빠르고, 토큰은 덜 써야 의미가 있다.
해결 방법 — LLM은 SQL을 쓰지 않고, 기록도 보지 않는다
Mnemento의 핵심 구조는 이렇습니다.
- SQLite 위의 JSON 문서 + 스키마 사전(schema registry) — 저장은 유연하게, 하지만 LLM은 항상 어떤 필드가 있는지 압니다.
- 이벤트 로그 + 현재 상태 — 모든 답은 자기가 센 기록을 근거로 댈 수 있습니다.
- Keeper 에이전트 — 유일한 기록 담당. 검증하고, 중복을 막고, 출처를 남기고, 확실하지 않으면 되묻습니다.
- MCP 서버 — Claude Code나 Claude Desktop에 바로 연결됩니다.
질문 하나가 답이 되는 과정은 세 단계입니다.
"10/2 사람인 지원 몇 곳?"
  ① interpret   rule-based fast path (no LLM) ─┐   or LLM → QuerySpec (sees only the relevant
                                               │      schema dictionary, never the records)
  ② query       QuerySpec ──code──▶ parameterised SQL on generated, indexed columns
  ③ answer      count / list / groups + evidence ids + warnings (small samples, incomplete
                periods, records too recent to have an outcome, resolved dates and names)
- 해석 — 형식이 정해진 질문은 LLM 없이 규칙으로 처리합니다. 나머지는 LLM이 관련 스키마 사전만 보고
QuerySpec이라는 구조화된 질의 계획을 씁니다. 사전에 없는 필드를 쓰면 거부하고 한 번 더 묻기 때문에, 존재하지 않는 필드를 짐작해서 조회하는 일이 없습니다. - 질의 —
QuerySpec을 코드가 파라미터화된 SQL로 바꾸고 SQLite가 실행합니다. 모델은 SQL을 직접 쓰지 않습니다. - 답변 — 개수·목록·그룹에 근거 id와 경고(표본이 작음, 기간이 아직 안 끝남, 해석한 날짜와 이름 등)를 붙여 돌려줍니다.
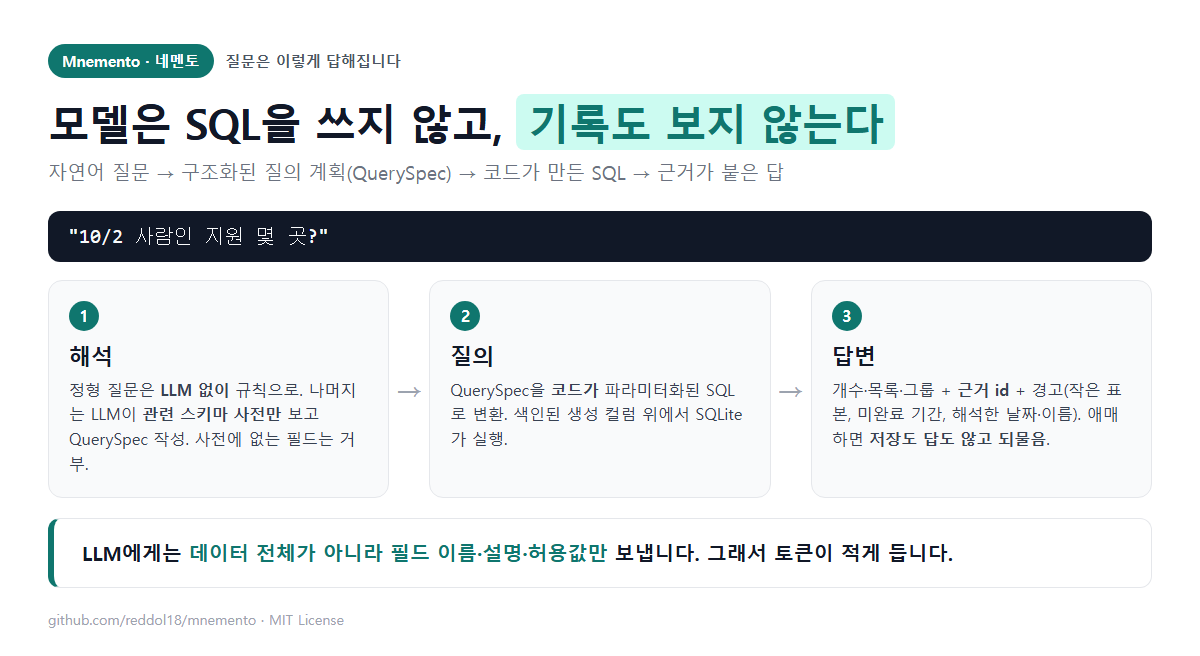
여기서 토큰이 절약되는 이유가 나옵니다. LLM에게는 기록 전체가 아니라 필드 이름·설명·허용값만 보냅니다. 기록이 100건이든 10,000건이든 LLM이 읽는 양은 거의 같습니다. 집계는 SQLite가 하니까요.
그 밖에도 실제로 써 보면서 넣은 장치들이 있습니다.
- 애매하면 되묻기 — “어느 회사?”, “어느 기록?”처럼 대상이 여럿이면 아무것도 저장하지 않고 선택지와 함께
clarify를 돌려줍니다. 비슷한 이름은 후보로만 보여 주고 자동으로 합치지 않습니다. - 먼저 저장, 나중에 정리 — 새로운 종류의 기록은 에이전트가 제안 스키마(
schema_draft)와 함께record하면 draft 종류로 바로 저장·조회되고, 사용자가apply_schema_proposal로 승인한 뒤부터 필수 필드·enum·색인이 적용됩니다. - 계측과 조회 로그 — 질문마다 단계별 시간, LLM 호출 수, 입력·출력 토큰, 비용을 기록합니다.
query_log도구로 최근 질문, 경고가 붙은 질문, 같은 질문인데 SQL이 달라진 것(diverging), 0건으로 끝난 답(empty)을 볼 수 있습니다.
벤치마크 — Claude Code 자체 메모리와 비교
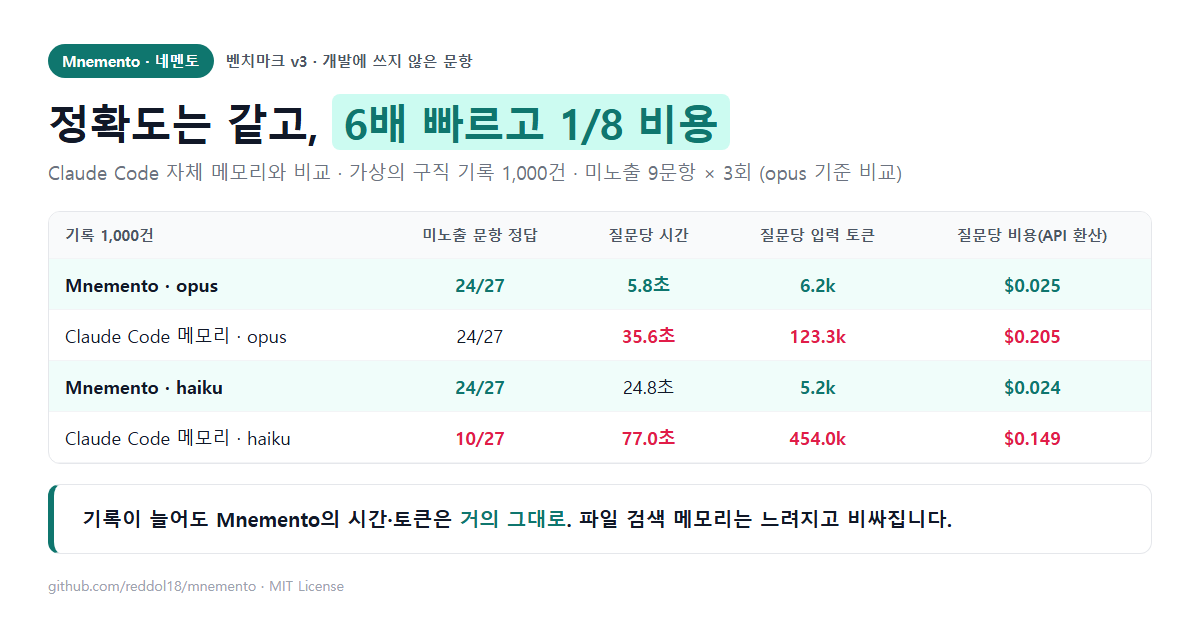
“정확도가 LLM 자체 메모리보다 낮으면 존재 이유가 없다”는 기준으로 세 번 측정했습니다. 비교 대상은 지금 제가 실제로 쓰던 방식, 즉 Claude Code 메모리(MEMORY.md 인덱스 + 기록당 마크다운 파일 하나, Grep/Read로 검색)입니다. 같은 가상의 구직 기록, 같은 답변 형식 힌트, 같은 모델로 3회씩 반복했습니다.
최신 측정(v3)에서 개발에 쓰지 않은 문항(unseen) 결과입니다.
| 기록 수 | 시스템 | 미노출 문항 정답 | 질문당 시간 | 질문당 입력 토큰 | 질문당 비용(API 환산) |
|---|---|---|---|---|---|
| 100 | Mnemento · opus | 27/27 | 5.9초 | 6.1k | $0.025 |
| 100 | Claude Code 메모리 · opus | 27/27 | 14.8초 | 36.9k | $0.058 |
| 1,000 | Mnemento · opus | 24/27 | 5.8초 | 6.2k | $0.025 |
| 1,000 | Claude Code 메모리 · opus | 24/27 | 35.6초 | 123.3k | $0.205 |
| 1,000 | Mnemento · haiku | 24/27 | 24.8초 | 5.2k | $0.024 |
| 1,000 | Claude Code 메모리 · haiku | 10/27 | 77.0초 | 454.0k | $0.149 |
정리하면 이렇습니다.
- opus 기준 정확도는 Claude Code 자체 메모리와 같습니다. 100건 27/27 대 27/27, 1,000건 24/27 대 24/27.
- 기록 1,000건에서는 6배 빠르고, 입력 토큰은 1/20, 비용은 1/8입니다.
- haiku에서는 Mnemento가 확실히 앞섭니다. Claude Code 메모리는 haiku에서 기록이 늘수록 무너졌습니다(미노출 정답률 70% → 37%).
- 기록이 늘어도 Mnemento의 시간과 토큰은 거의 그대로였습니다. 파일 검색 메모리는 100건에서 1,000건으로 가면서 시간 2.4배, 비용 3.6배가 됐습니다.
솔직하게 적어 둘 부분도 있습니다. 처음부터 이긴 건 아닙니다. 첫 측정(v0)과 두 번째 측정(v2)에서는 기록이 적을 때 Claude Code 자체 메모리가 더 정확했습니다(v2 opus 기준 83/87 대 75/87). 틀린 문항을 하나씩 분석해서 고친 뒤, 새 평가셋과 새로 쓴 미노출 문항으로 다시 잰 것이 v3입니다. 개발 문항 점수는 그 문항으로 고쳤으니 과적합일 수 있어서, 비교는 미노출 문항 기준으로 봐야 합니다. 경과 시간 조건(“지원하고 3일 넘게 지나서 열람된 곳”) 같은 질문은 측정 시점에 아직 표현하지 못했고, 이후 보완했지만 그 효과는 아직 새로 측정하지 않았습니다. 이전 측정 결과와 문항별 결과는 README에 그대로 남겨 두었습니다.
구직 기록만이 아니다 — 투자 기록, 몸무게 같은 측정값까지
같은 장부에 질의 코드는 그대로 두고 스키마만 더해서 다른 도메인도 담을 수 있습니다. 저는 실제로 제 투자 기록(종목·체결·판단·매수 기준·보유 현황)을 로컬에서 Mnemento로 관리하고 있습니다. 저장소에는 가상 예시만 들어 있습니다.
"가상바이오(900001) 몇 번 샀어?"     -> trade, count, 종목 코드로 종목 확정   -> 2
"올해 손절한 종목은?"                 -> trade, sell, pnl < 0, 올해            -> 목록
"왜 그 종목은 안 사기로 했지?"        -> 기록된 이유를 그대로 인용             -> 텍스트 + 근거
- 식별자 우선 — 종목 코드나 사업자번호처럼
identifier로 표시한 필드가 질문에 있으면 그것으로 먼저 찾습니다. - 시계열(series) — 몸무게, 일일 지출, 주가처럼 반복해서 재는 값도 담을 수 있습니다. 기간 평균, 변화량, 최근 4주 이동평균과의 비교 같은 질문을 코드가 만든 SQL로 답합니다.
- 기존 메모 가져오기 — 마크다운 메모리 파일을
ingest_preview로 읽으면 무엇을 기록할지 미리 보여 주고, 사용자가 동의해야ingest_apply로 저장합니다. 저장된 값은 모두 원문 인용을 달고 있고, 원문에 없는 값은 버립니다.
설치와 사용법 — Claude Code에 MCP 서버로 연결하기
uv와 Python 3.11 이상이 필요합니다. 설치는 이렇게 합니다:
git clone https://github.com/reddol18/mnemento.git
claude mcp add mnemento -e MNEMENTO_DB="$HOME/.mnemento/mnemento.db" -- uv --directory /path/to/mnemento run mnemento-mcp
Claude Desktop이라면 claude_desktop_config.json에 같은 명령을 넣으면 됩니다:
{ "mcpServers": { "mnemento": {
    "command": "uv", "args": ["--directory", "/path/to/mnemento", "run", "mnemento-mcp"],
    "env": { "MNEMENTO_DB": "/path/to/mnemento.db" } } } }
쓸 수 있는 도구는 query, record, record_series, revert_series_batch, get_entity, history, list_schemas, propose_schema, apply_schema_proposal, query_log, purge_query_log입니다.
- 자연어 해석에는 이미 로그인해 둔 Claude Code CLI를 그대로 씁니다. 따로 API 키가 필요 없습니다(
MNEMENTO_LLM=claude-cli, 기본 모델sonnet,MNEMENTO_MODEL=haiku처럼 바꿀 수 있음). MNEMENTO_LLM=none으로 두면 LLM 없이 규칙 기반 경로와 구조화된QuerySpec만 처리합니다.
실제 사용 흐름은 단순합니다. 에이전트에게 평소처럼 “오늘 ○○에 지원했어, 기록해 줘”라고 하면 Keeper가 검증해서 장부에 넣고, 나중에 “이번 주에 지원한 곳 몇 곳이야?”라고 물으면 개수와 함께 어떤 기록들로 셌는지 근거 id가 같이 옵니다. 애매하면 마음대로 고르지 않고 되묻고요.
마치며 — 레너드의 폴라로이드처럼
영화 메멘토에서 레너드를 버티게 한 건 기억력이 아니라 기록하는 습관과 그 기록을 믿을 수 있는 구조였습니다. 문제는 그 메모가 틀렸을 때였죠.
LLM 에이전트도 같습니다. 기억을 늘리는 것보다 중요한 건 기록을 정확하게 남기고, 셀 때 근거를 대고, 확실하지 않으면 되묻는 것입니다. 네멘토는 그 일을 맡는 “너의 멘토”가 되려고 만들었습니다.
설계 결정 기록(ADR)과 벤치마크 원자료까지 모두 공개해 두었습니다. 써 보시고 이슈나 의견 남겨 주시면 반영하겠습니다.
Comments